LLM 是一个函数
想发散就少给输入,想收敛就多加约束——控制的不是「更努力地描述」,而是输入的量与约束的强度。
LLM 是一个函数。你给它什么,它就还你什么。
当你要发散性思维的时候,就少给它一些输入:输入越少,解空间越大,它才可能给出你没想到的方向。过早把自己的答案塞进去,拿回来的往往只是自己答案的回声。
当你要开始收敛的时候,就多加一些约束:格式、边界、标准越明确,输出越确定、越接近能直接使用的结果。
发散靠减法,收敛靠加法——同一个函数,旋钮在你手上。
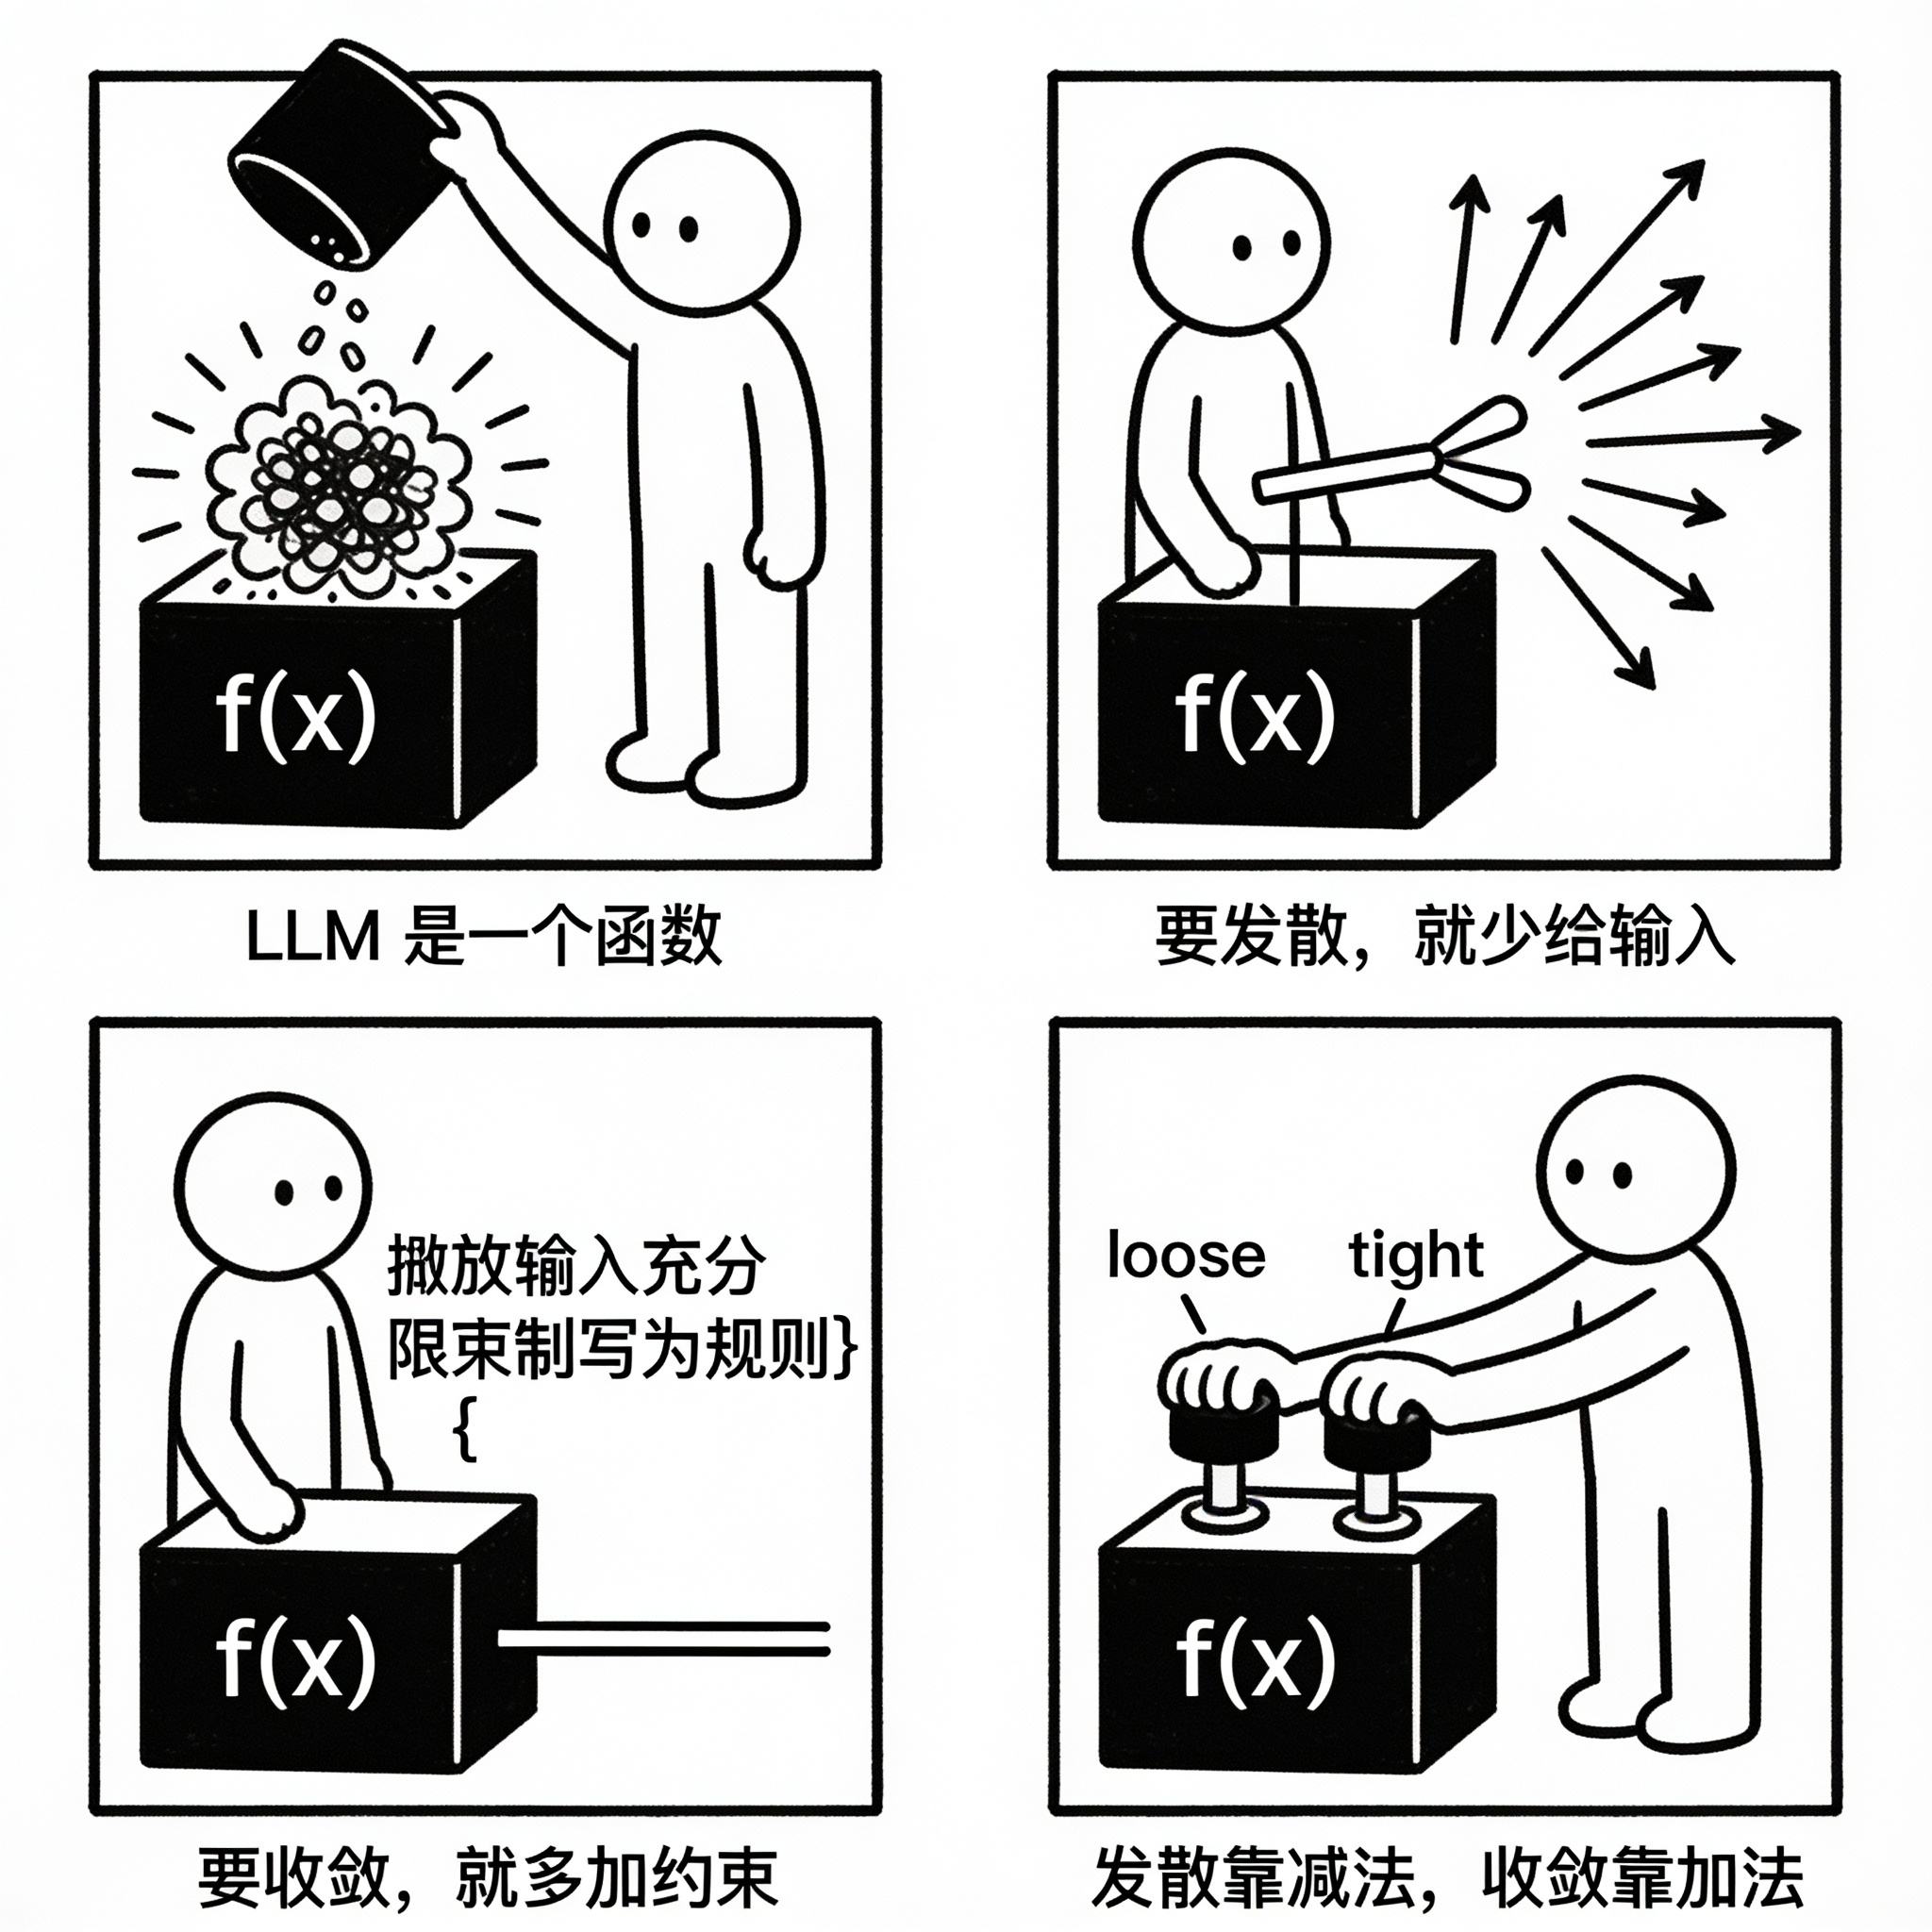
想发散就少给输入,想收敛就多加约束——控制的不是「更努力地描述」,而是输入的量与约束的强度。
LLM 是一个函数。你给它什么,它就还你什么。
当你要发散性思维的时候,就少给它一些输入:输入越少,解空间越大,它才可能给出你没想到的方向。过早把自己的答案塞进去,拿回来的往往只是自己答案的回声。
当你要开始收敛的时候,就多加一些约束:格式、边界、标准越明确,输出越确定、越接近能直接使用的结果。
发散靠减法,收敛靠加法——同一个函数,旋钮在你手上。
当 AI 把代码变成新的抽象层,新一代开发者是否会像今天忽略内存一样不再阅读代码?
没有经历过“古法编程”的新一代开发者,是否真的会逐渐不再看代码?
这也许并非完全不可想象。今天使用第三代、第四代语言的开发者,通常不会持续关心每一次内存分配或底层指令;更高层的抽象让我们把注意力放到意图和结果上。
当 AI 成为新的抽象层,代码会不会也像内存一样退到幕后?未来真正重要的能力,可能不再是逐行阅读代码,而是能否表达清楚问题、验证结果,并在系统出错时承担责任。
如果不看代码成为常态,边界在哪里?这究竟是编程自然演进的未来,还是把尚未解决的风险藏进了一个更大的黑盒?
