LLM 是一个函数
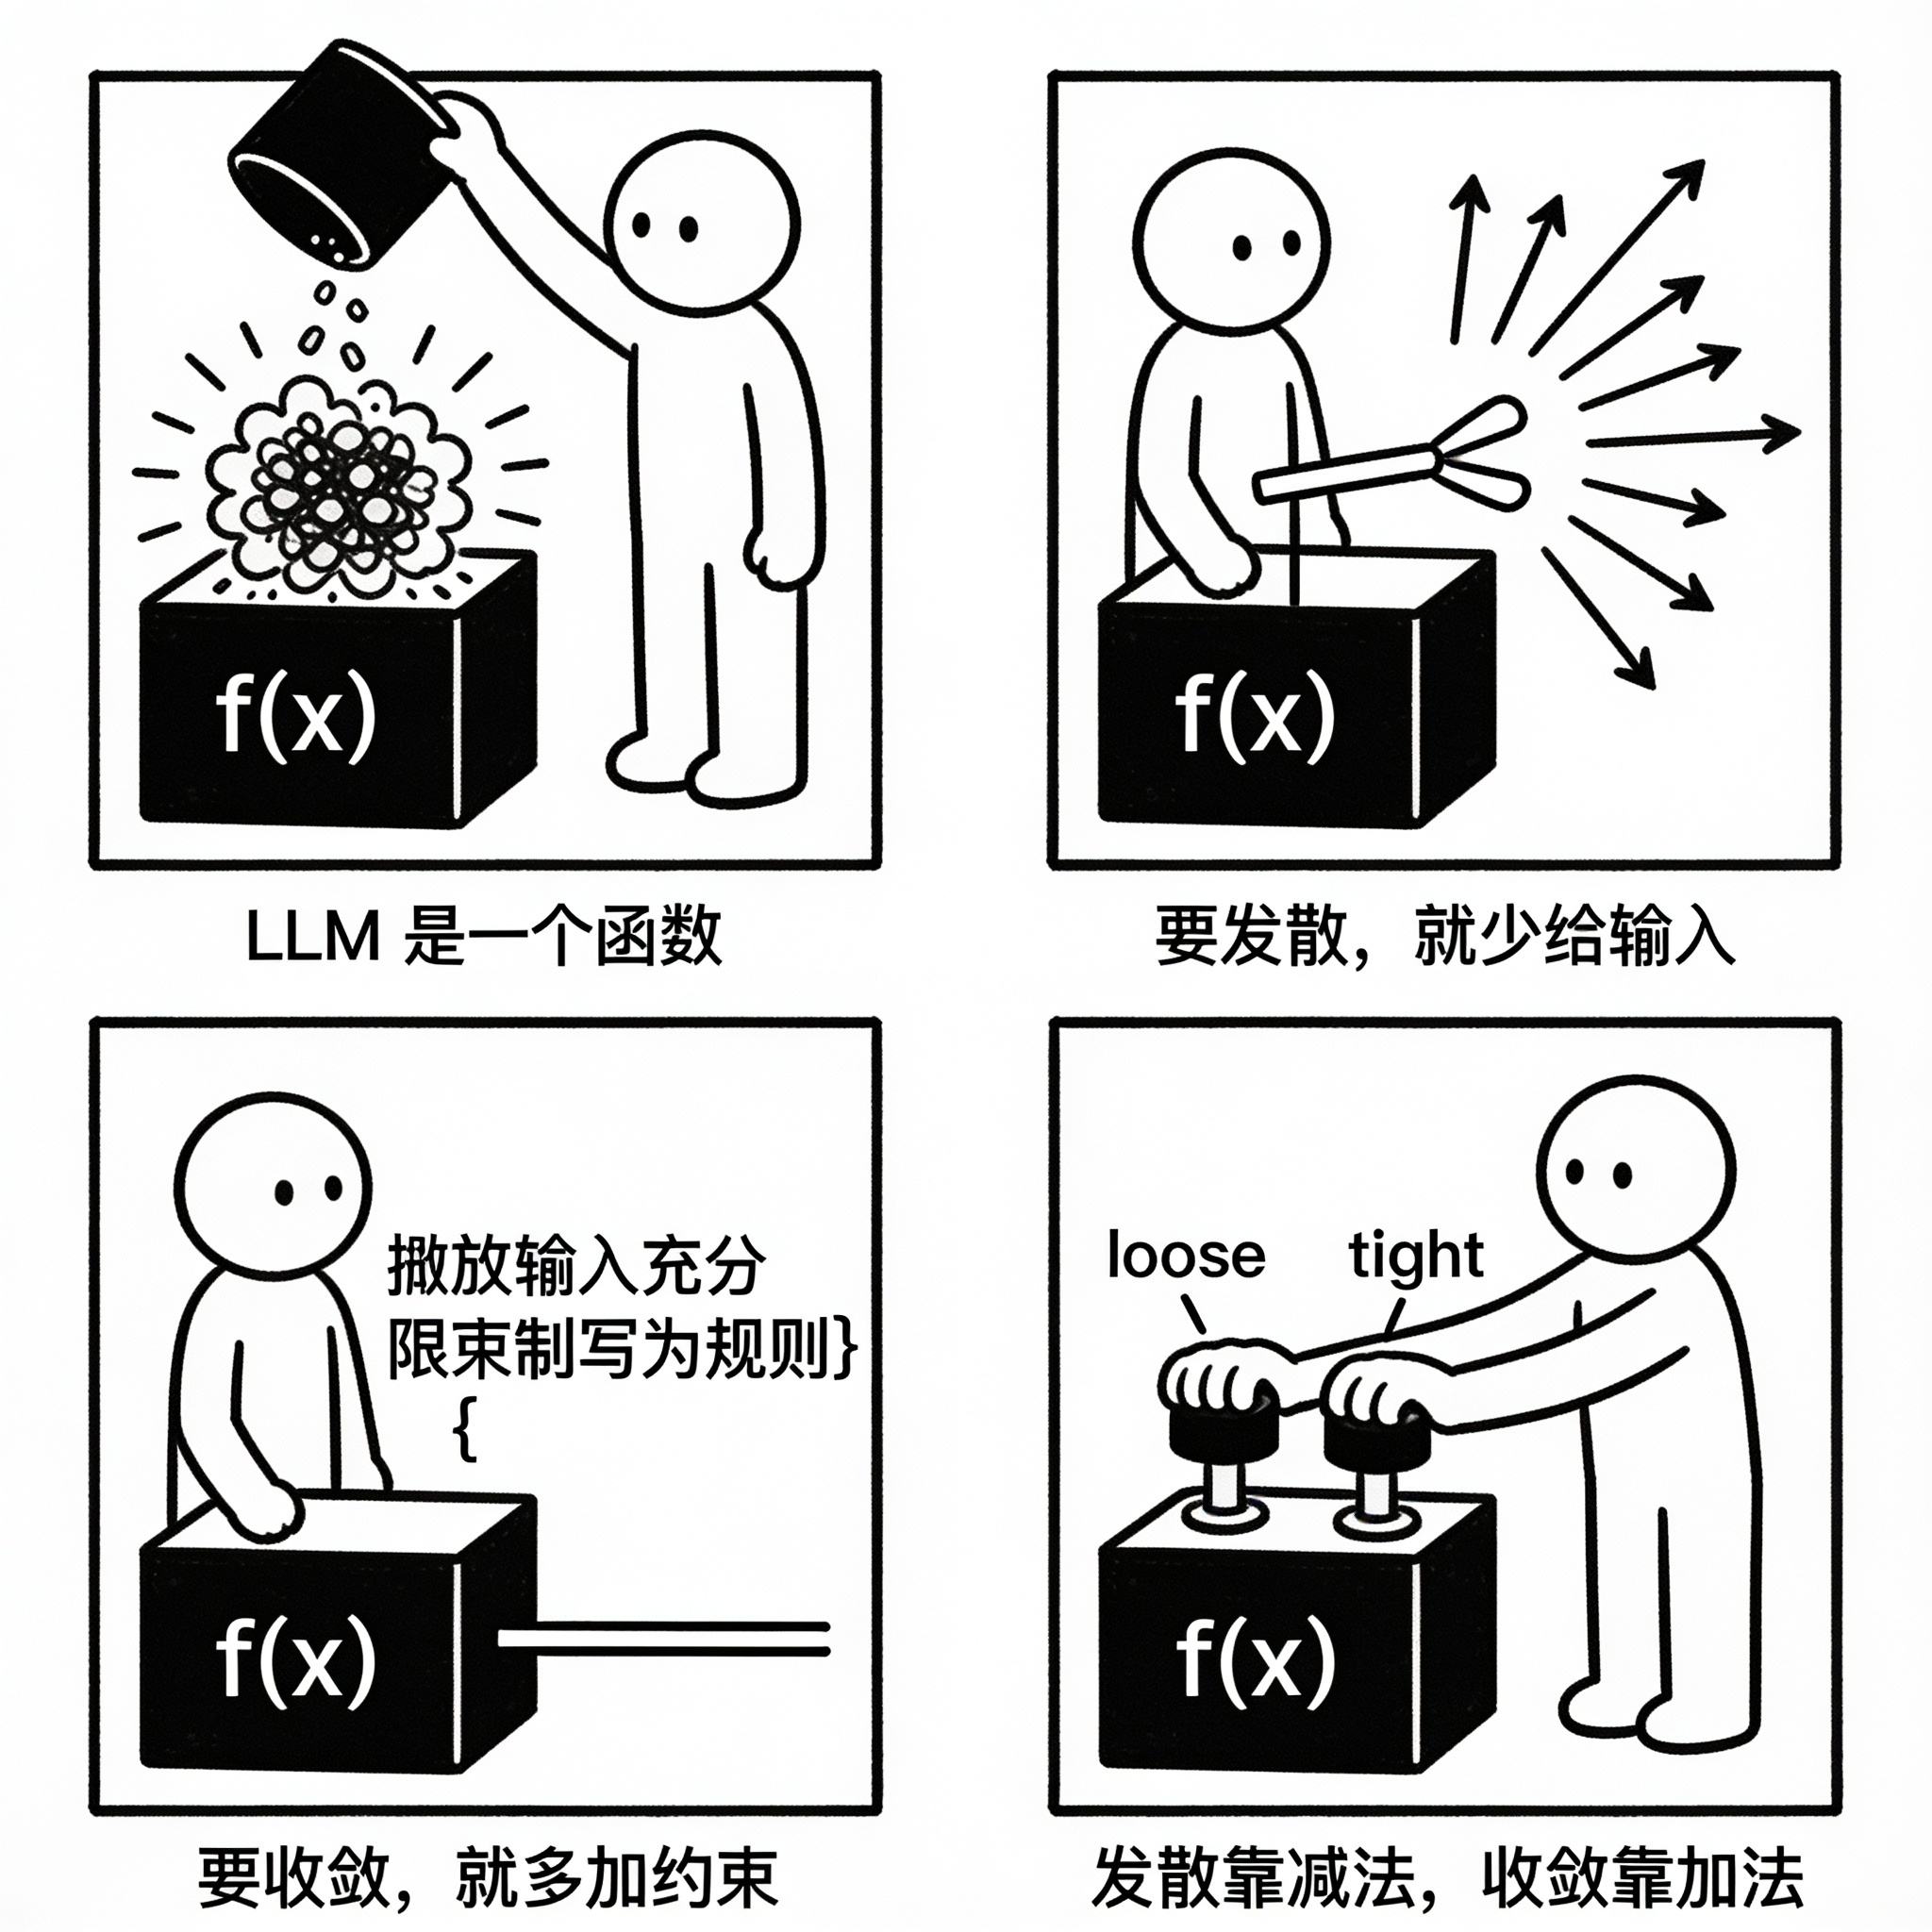
想发散就少给输入,想收敛就多加约束——控制的不是「更努力地描述」,而是输入的量与约束的强度。
LLM 是一个函数。你给它什么,它就还你什么。
当你要发散性思维的时候,就少给它一些输入:输入越少,解空间越大,它才可能给出你没想到的方向。过早把自己的答案塞进去,拿回来的往往只是自己答案的回声。
当你要开始收敛的时候,就多加一些约束:格式、边界、标准越明确,输出越确定、越接近能直接使用的结果。
发散靠减法,收敛靠加法——同一个函数,旋钮在你手上。
想发散就少给输入,想收敛就多加约束——控制的不是「更努力地描述」,而是输入的量与约束的强度。
LLM 是一个函数。你给它什么,它就还你什么。
当你要发散性思维的时候,就少给它一些输入:输入越少,解空间越大,它才可能给出你没想到的方向。过早把自己的答案塞进去,拿回来的往往只是自己答案的回声。
当你要开始收敛的时候,就多加一些约束:格式、边界、标准越明确,输出越确定、越接近能直接使用的结果。
发散靠减法,收敛靠加法——同一个函数,旋钮在你手上。