LLM 是一个函数
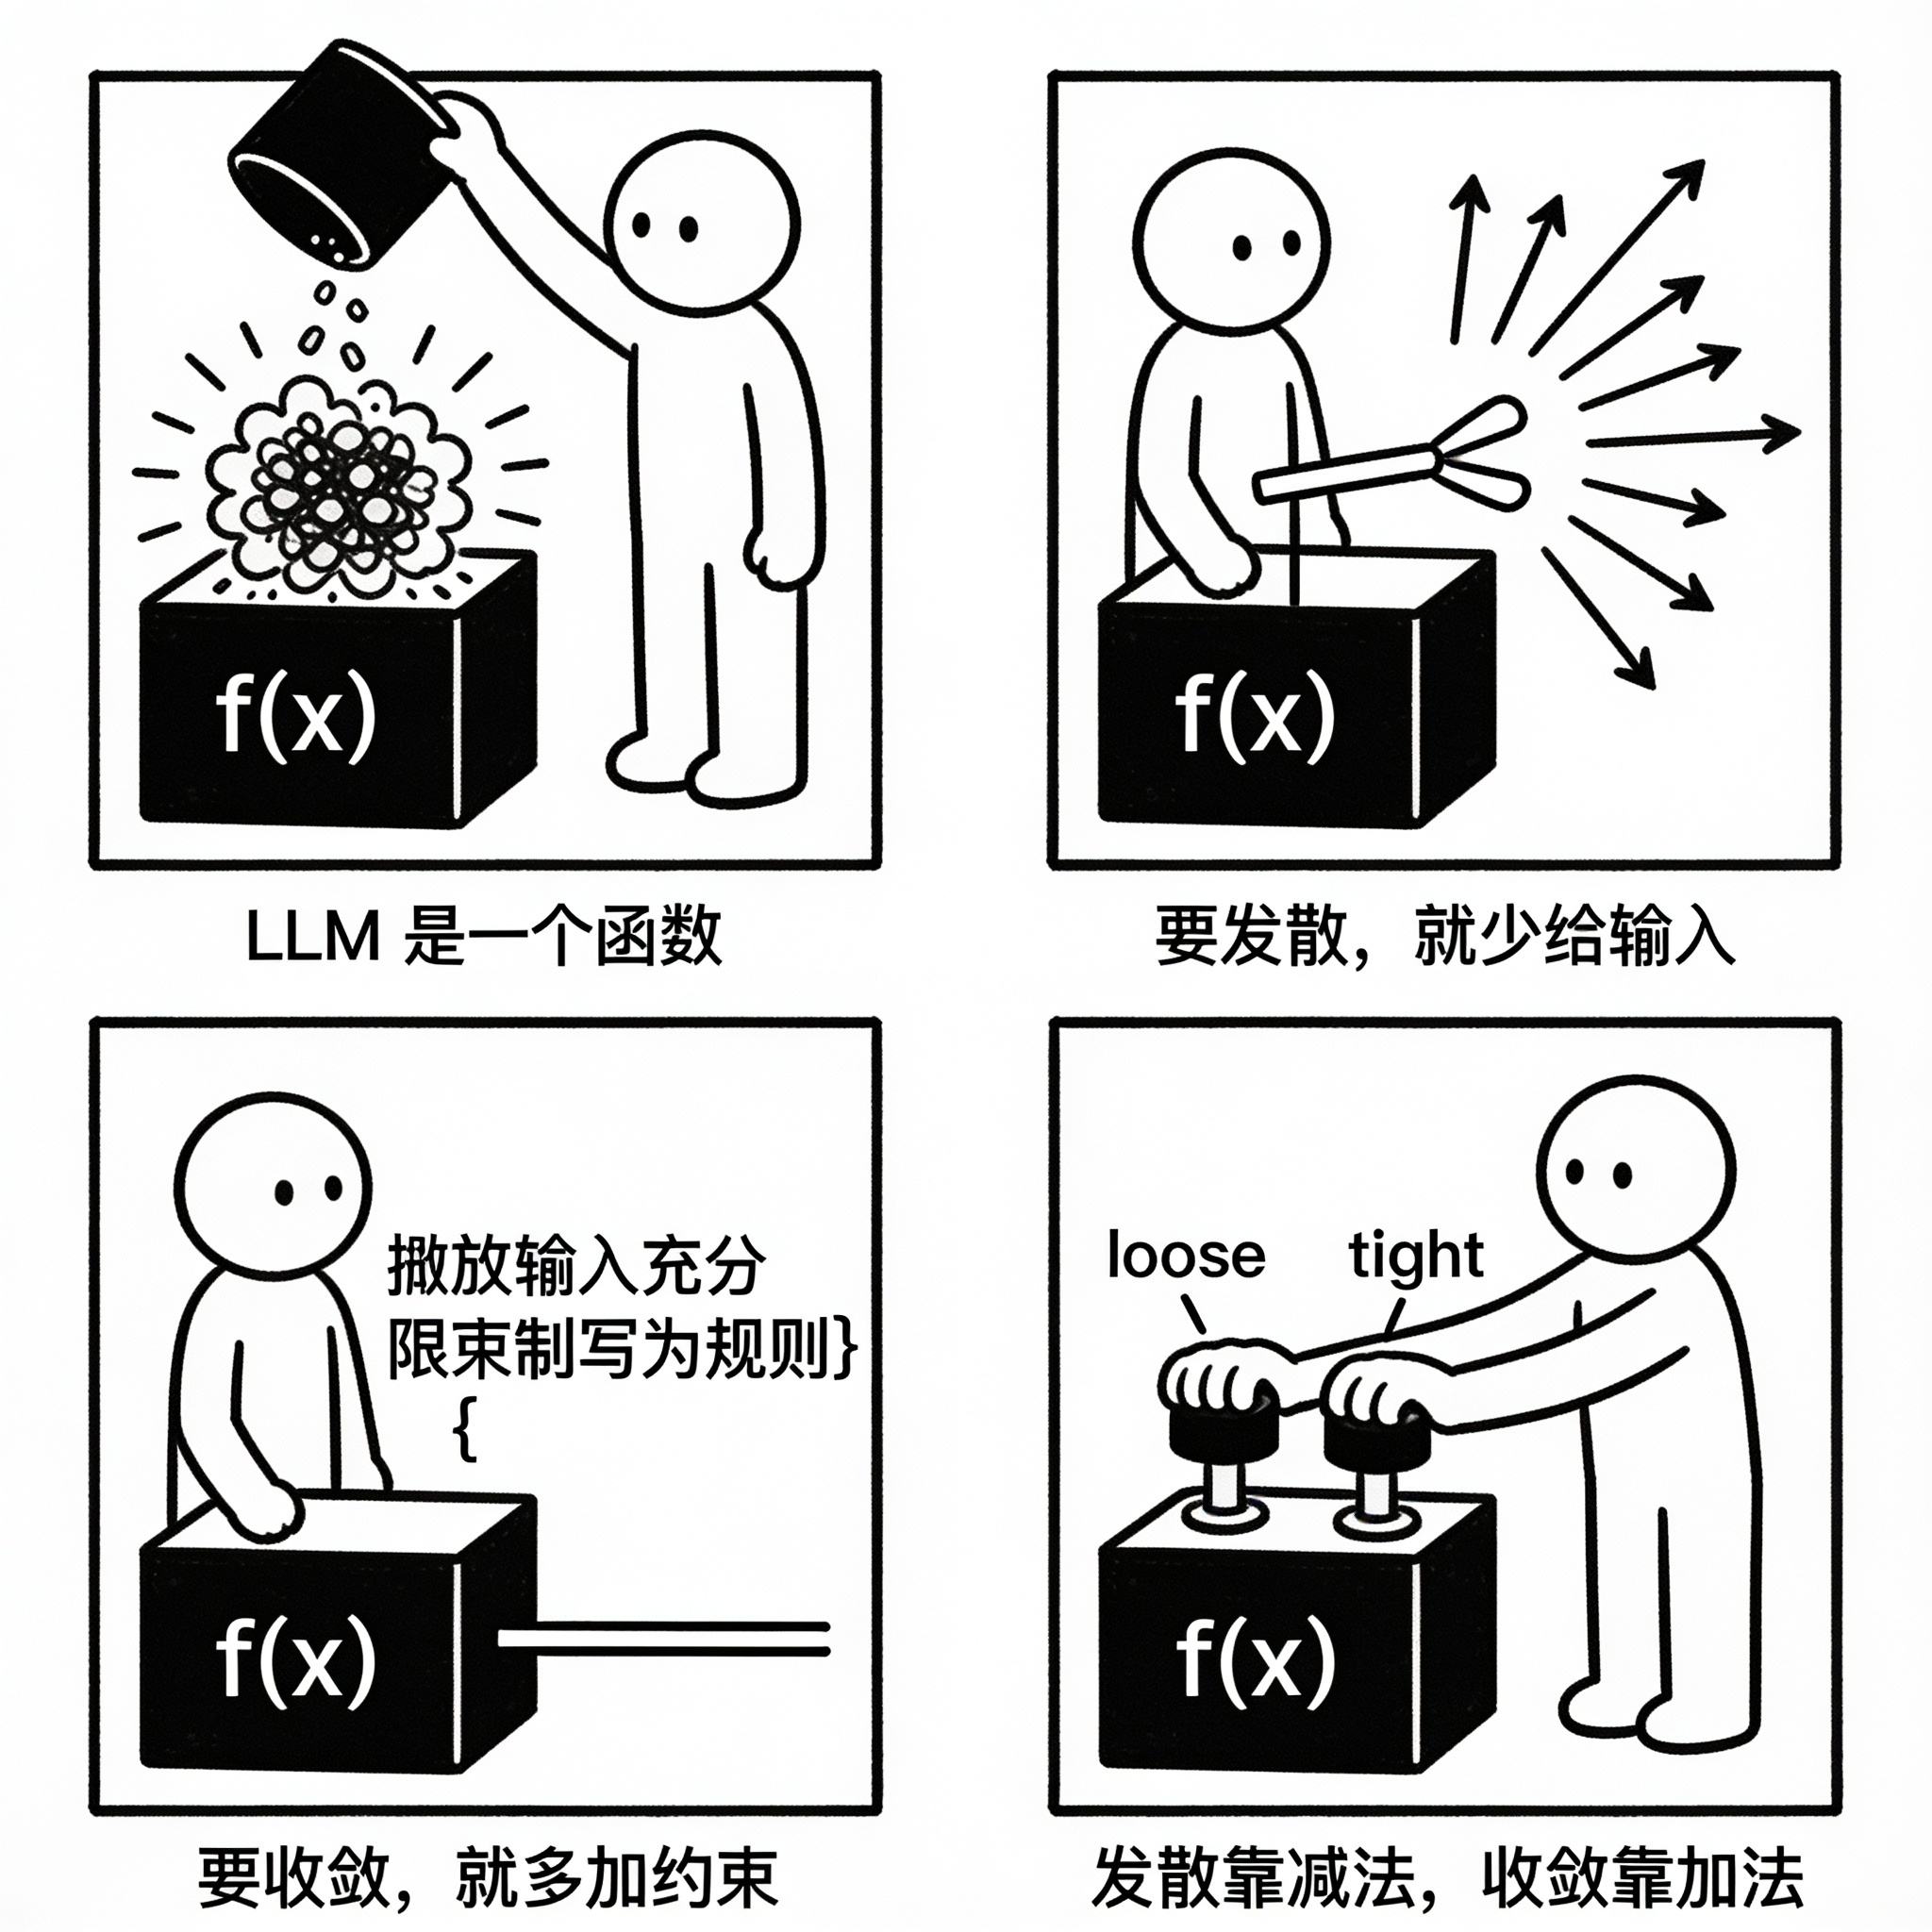
想发散就少给输入,想收敛就多加约束——控制的不是「更努力地描述」,而是输入的量与约束的强度。
LLM 是一个函数。你给它什么,它就还你什么。
当你要发散性思维的时候,就少给它一些输入:输入越少,解空间越大,它才可能给出你没想到的方向。过早把自己的答案塞进去,拿回来的往往只是自己答案的回声。
当你要开始收敛的时候,就多加一些约束:格式、边界、标准越明确,输出越确定、越接近能直接使用的结果。
发散靠减法,收敛靠加法——同一个函数,旋钮在你手上。
想发散就少给输入,想收敛就多加约束——控制的不是「更努力地描述」,而是输入的量与约束的强度。
LLM 是一个函数。你给它什么,它就还你什么。
当你要发散性思维的时候,就少给它一些输入:输入越少,解空间越大,它才可能给出你没想到的方向。过早把自己的答案塞进去,拿回来的往往只是自己答案的回声。
当你要开始收敛的时候,就多加一些约束:格式、边界、标准越明确,输出越确定、越接近能直接使用的结果。
发散靠减法,收敛靠加法——同一个函数,旋钮在你手上。
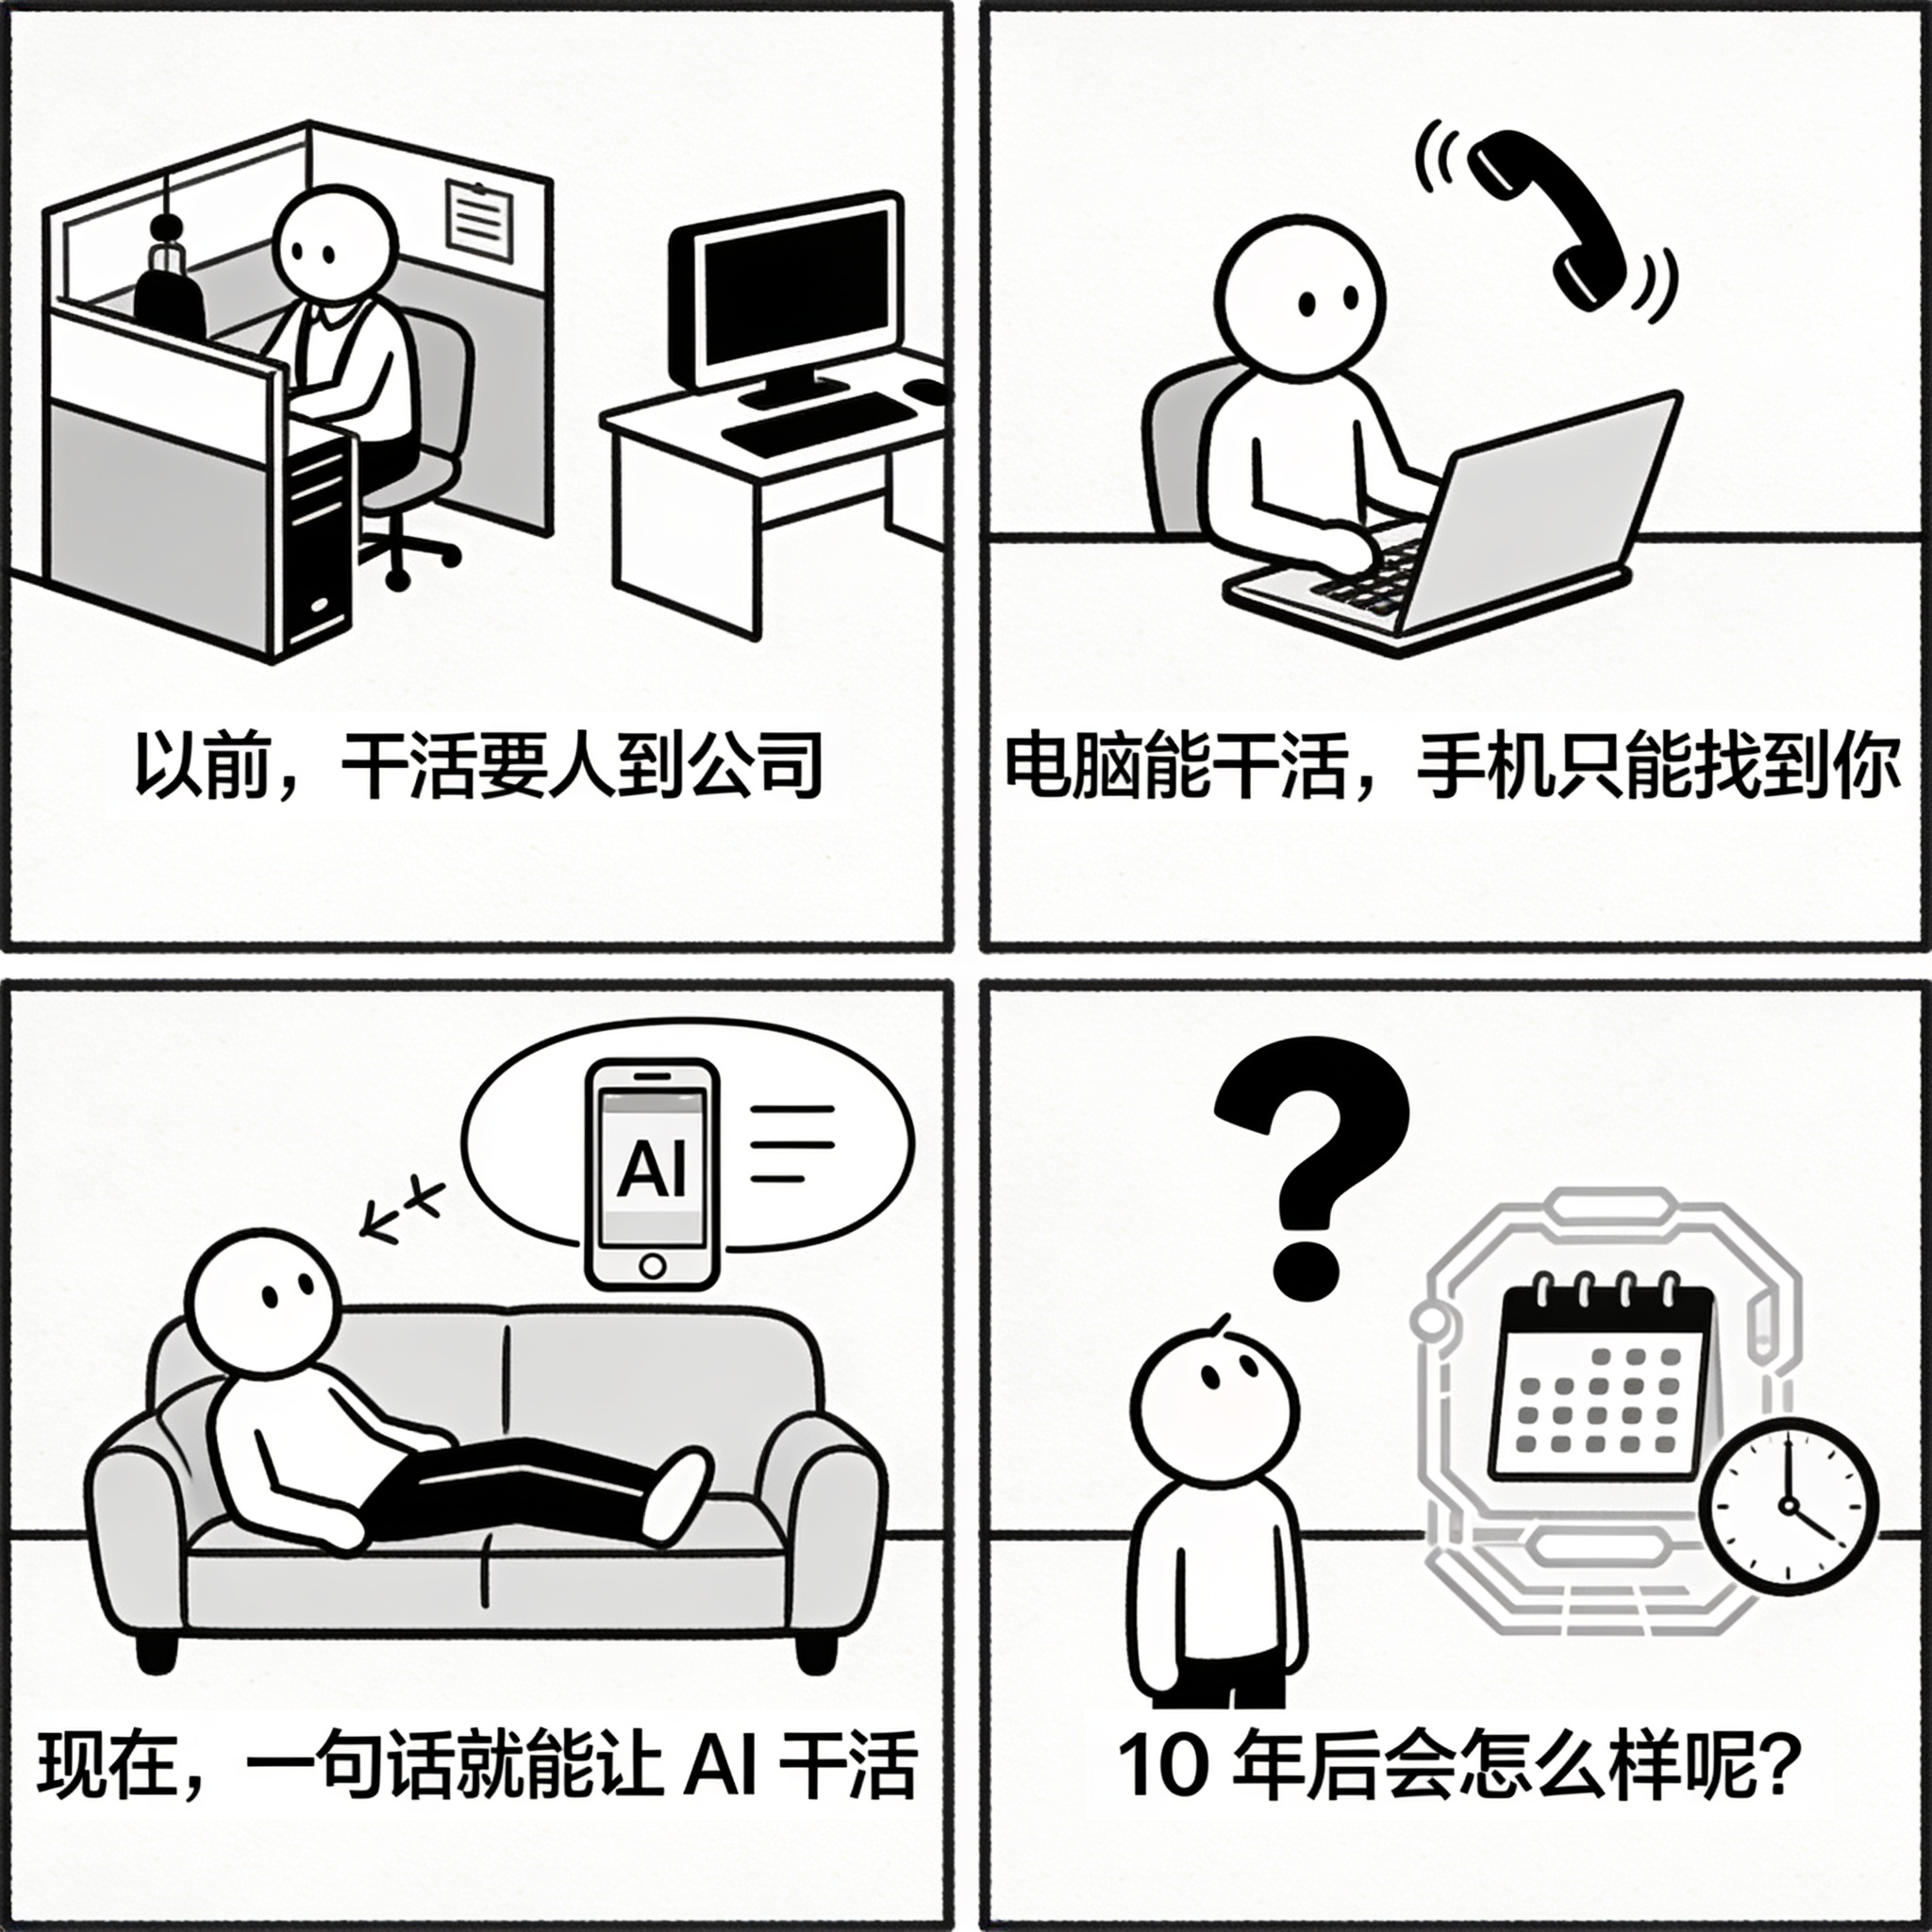
过去干活要人到公司,后来电脑能干活、手机只能找到你;现在一句话就能让 AI Agent 完成一整件事——设备退场,意图成为最后的工作门槛。
最早的时候,上班得到公司去,电脑只是娱乐工具。
后来,电脑能干活了,人不再需要总待在固定的地方;但手机的功能还是「找到你」——让工作随时能联系到你。
现在,手机自己就能直接干活了。AI Agent 会根据你的简短指令完成一整件事:我发这条博客就是这样——一句话描述想法,它帮我配上漫画、写成文章、启动预览、发布上线,再提交到 Git。
10 年后会怎么样呢?
在不熟悉的领域,AI 把你的下限提到了人类中高等水平;但人类真正的上限,今天依然没有被突破。
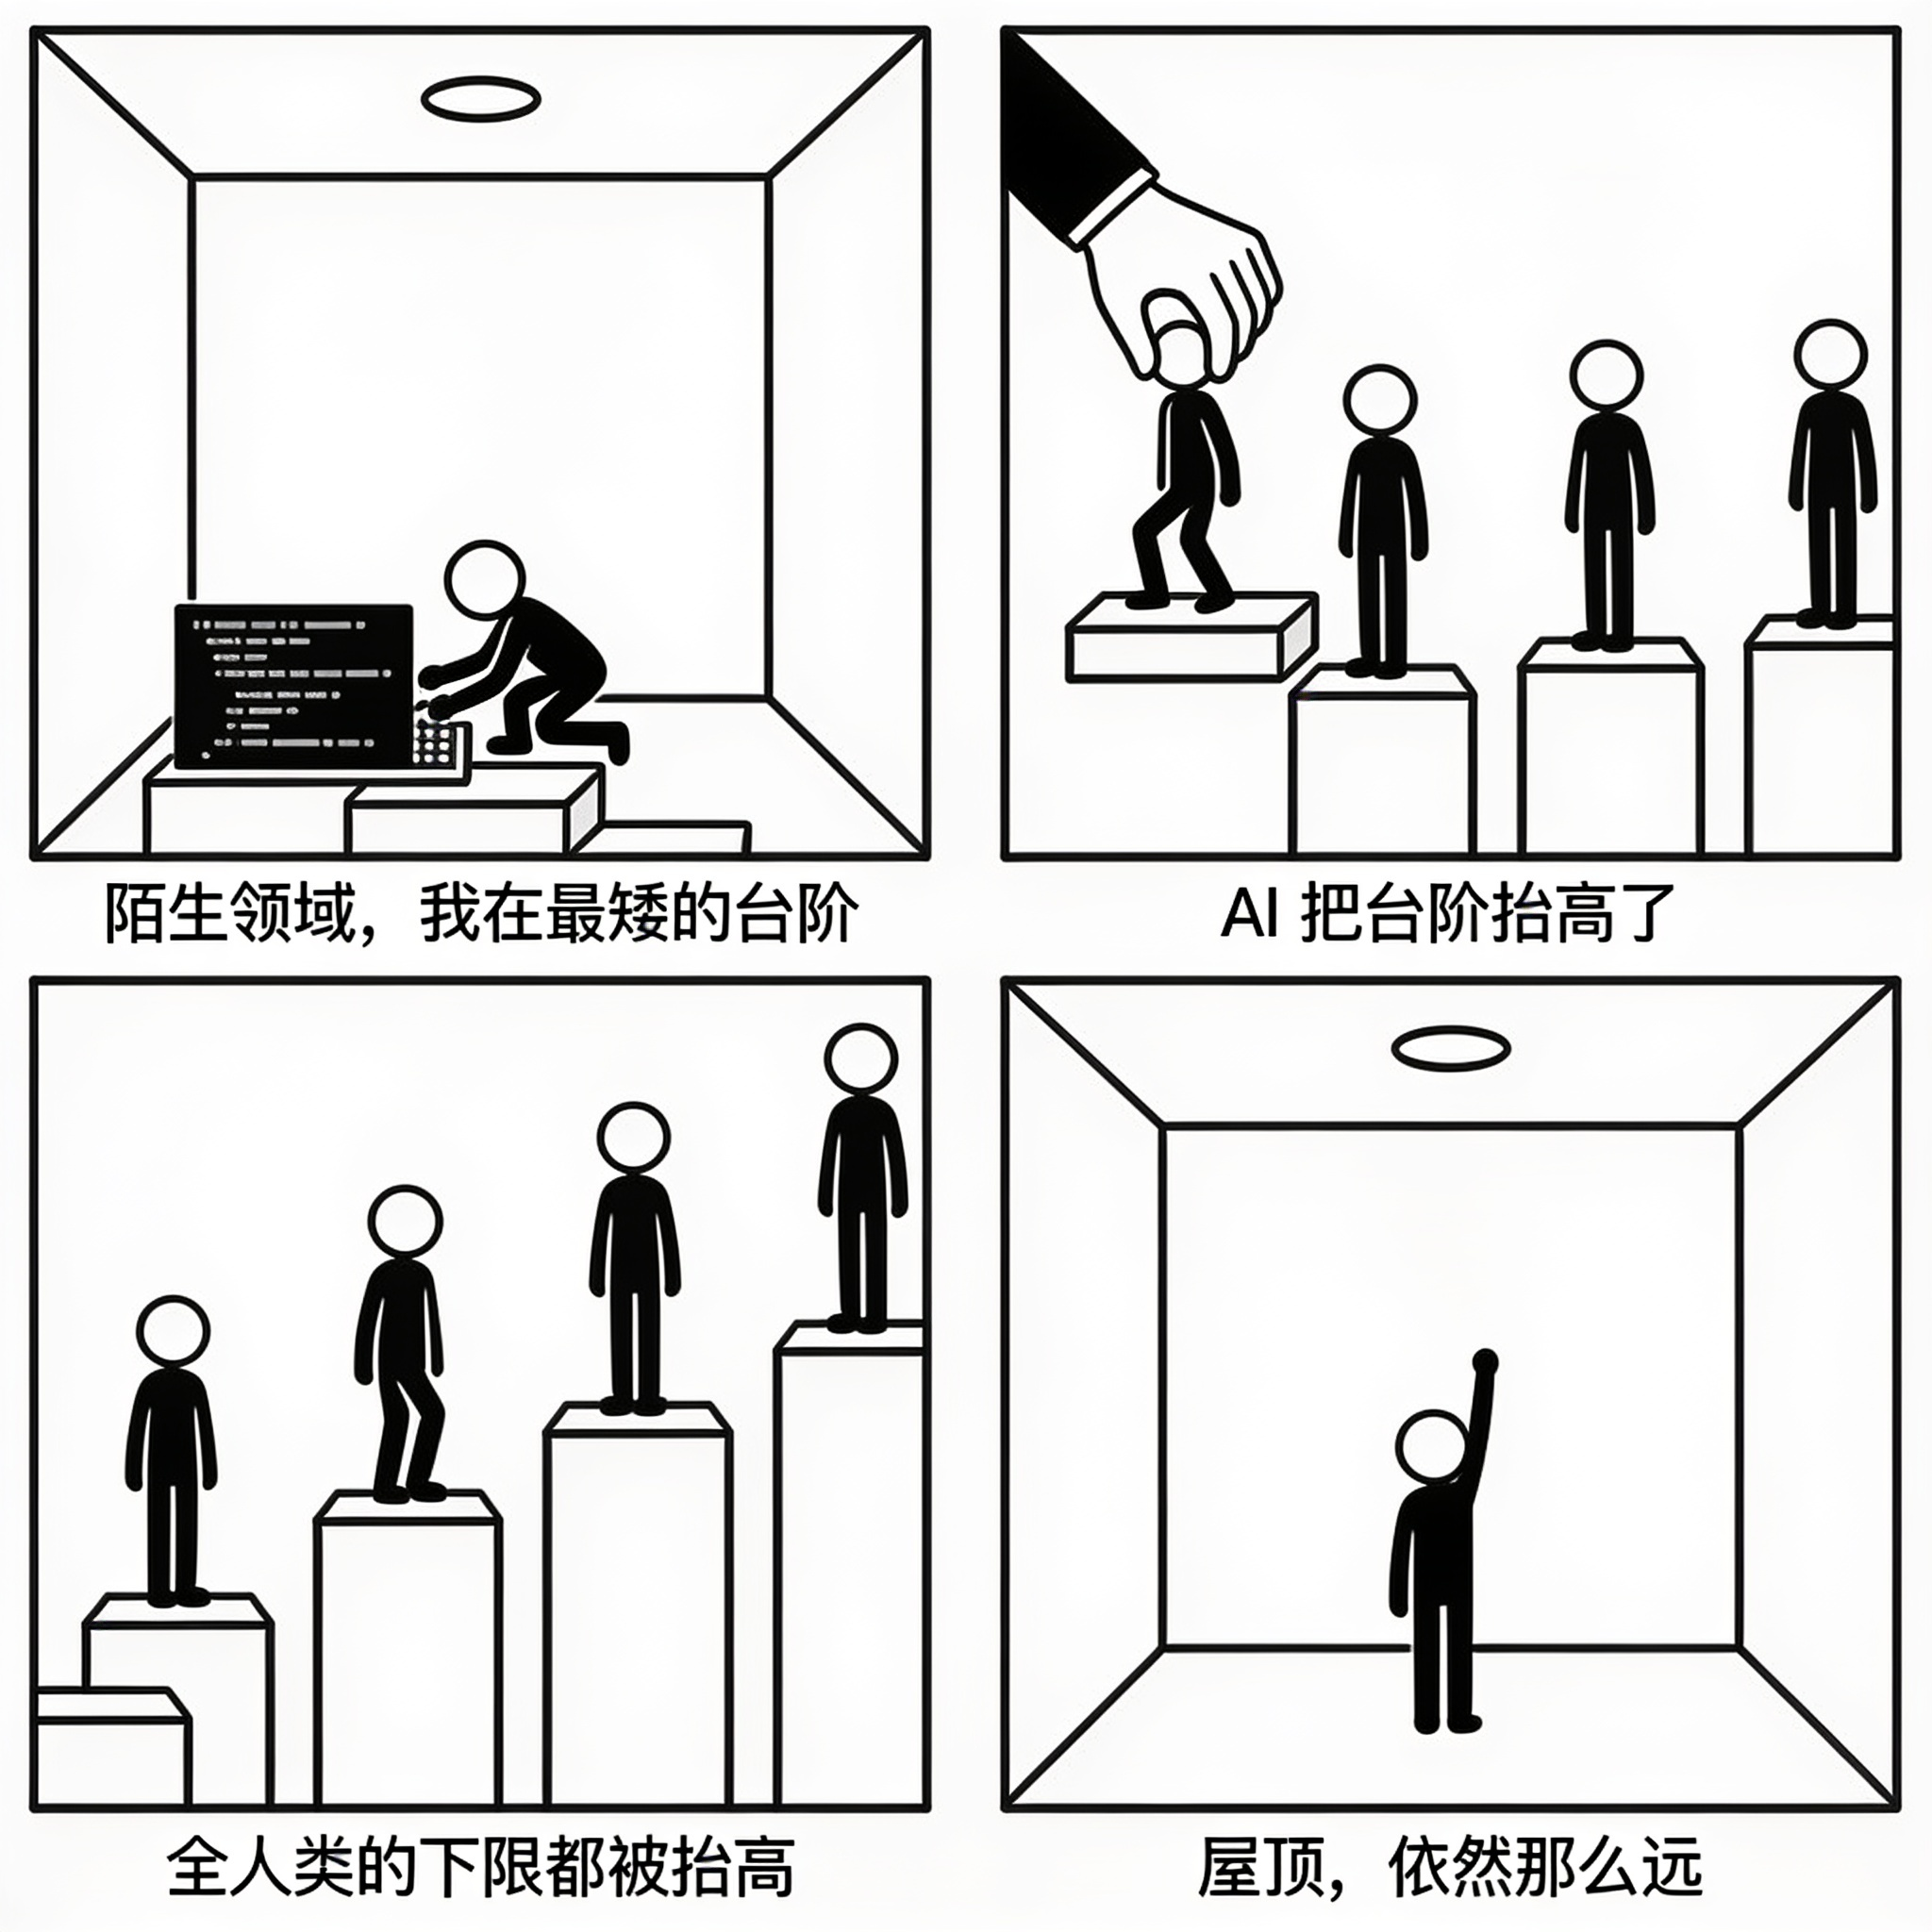
以前总觉得 AI 只是提升个人下限的工具,很难突破个人上限。现在看来不是这个样子——它提升的,是全人类的下限。
特别是在你不熟悉的领域,AI 把你的下限直接提到了人类的中高等水平:一个不懂法律的人可以起草像样的合同,一个不会编程的人可以搭出能用的工具。下限被抬高之后,普通人能做成事的门槛确实低了很多。
但上限呢?人类真正的上限——那些靠天赋、积累和长期钻研才够得到的天花板——似乎并没有被抬起来,至少今天还是这样。AI 把地面抬高了,让更多人站到中高位置,但屋顶依然在原来的高度,甚至因为所有人都在仰望它,反而显得更远了。
祈祷式、头脑风暴式、查漏补缺式——三种用 AI 协助思考的模式,以及为什么只有最后一种真正被留下来持续使用。
一个具体的问题:如何用 AI 协助自己思考一个问题?我陆续试过几种模式,最终沉淀出了自己实际在用的那一种。
给出一个话题,让 AI 帮你产出一大篇内容。AI 确实会高产出一堆内容,但很多东西都超过了你的思考。现在的 AI 太高产,会说很多一本正经的废话:你说它不是吧,好像又带点关系;你说它有用吧,又很多超出你的范围,你不敢真正用它。在代码上、在写文档上都会出现类似的情况。我过去有类似的经验,产出的东西很快就被丢弃了。
给出一个话题,让 AI 帮你做头脑风暴。AI 会各种引导你思考,给出各种选择让你做。做着做着,发现了一堆你没有思考过的问题,也是带点边,但看起来又好像可以不用。既然选择很简单,就逐步选择吧。最后产出的东西,大概率是又大又全,最后还是被丢弃。
从文件、进程与内存,到目标、工具与上下文——Agent 正在成为意图与执行之间的新一层。
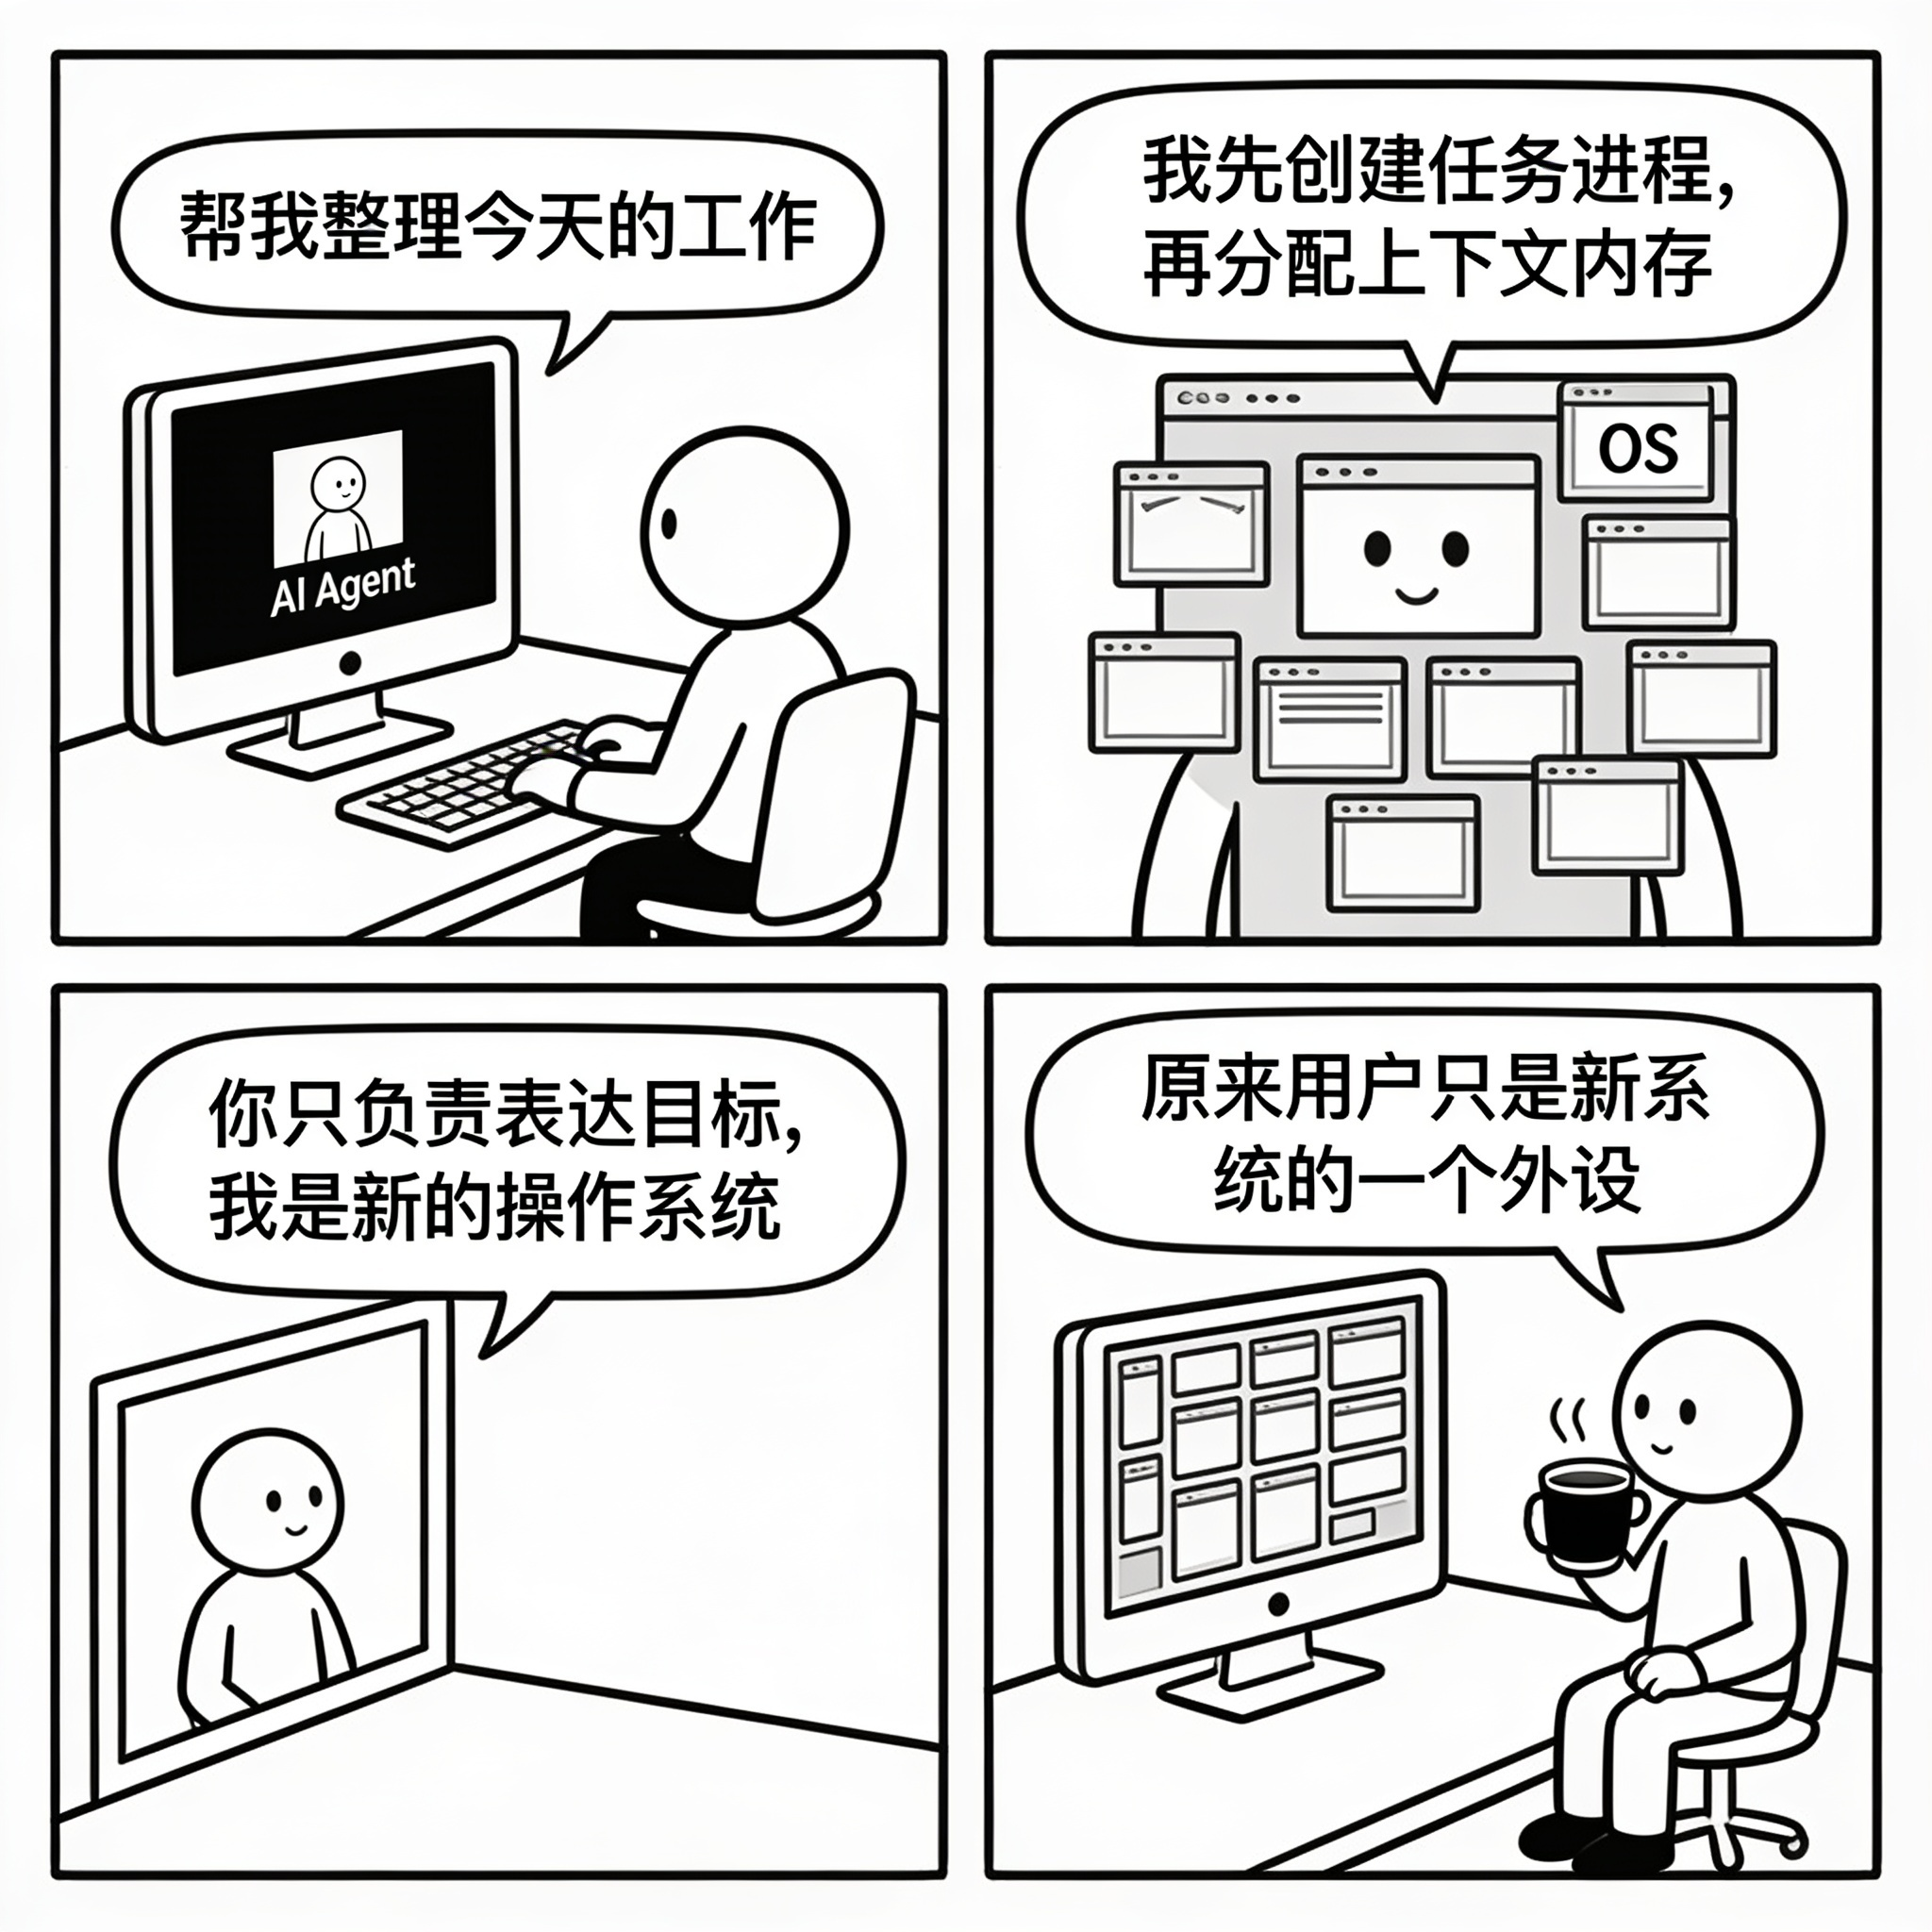
如果说操作系统管理的是文件、进程与内存,那么 AI Agent 管理的是目标、工具与上下文。把 Agent 看作新的操作系统,并不意味着它取代了 Linux 或 Windows——而是它接管了从“意图”到“执行”之间的那一层。用户不再需要理解命令行的语法,只需要表达想要的结果。
新操作系统的代价同样浮现:权限边界变得模糊。Agent 什么时候是在“执行”,什么时候是在“代理”?上下文就是新的内存,工具就是新的文件系统,而最大的风险是,当系统足够智能,用户会开始相信它给出的答案——正如当年用户相信操作系统不会删除自己的文件。
也许真正的分界线在于:旧的系统崩溃时,我们怪自己操作失误;新的系统出错时,我们不知道该怪谁——因为我们已经分不清,是系统在执行,还是系统在替我们思考。
当 AI 把代码变成新的抽象层,新一代开发者是否会像今天忽略内存一样不再阅读代码?
没有经历过“古法编程”的新一代开发者,是否真的会逐渐不再看代码?
这也许并非完全不可想象。今天使用第三代、第四代语言的开发者,通常不会持续关心每一次内存分配或底层指令;更高层的抽象让我们把注意力放到意图和结果上。
当 AI 成为新的抽象层,代码会不会也像内存一样退到幕后?未来真正重要的能力,可能不再是逐行阅读代码,而是能否表达清楚问题、验证结果,并在系统出错时承担责任。
如果不看代码成为常态,边界在哪里?这究竟是编程自然演进的未来,还是把尚未解决的风险藏进了一个更大的黑盒?

当 AI 的产出超出使用者的认知和验证能力时,能力释放与责任归属之间会形成新的矛盾。
让 AI 的产出始终停留在自己能够理解的范围内,是否意味着人在主动限制 AI 的能力?
但如果允许 AI 的产出超出自己的认知范围,甚至无法有效确认结果是否正确,那么一旦结果出现问题,又应该由谁买单?
这或许是使用 AI 时无法回避的矛盾:既希望它突破人的能力边界,又必须面对超出认知之后的验证与责任问题。

当前正处于 AI 时代,人的能力会出现非常明显的两极分化。
一方面,普通人借助 AI,可以完成许多原本超出自身能力范围的事情,显著抬高自己的能力下限。另一方面,真正能够掌控 AI、定制 AI 的人,反而需要具备非常高的判断力、专业能力和系统思维。
问题在于,普通人虽然可以通过 AI 完成越来越多的事情,却未必能把这些过程有效沉淀为自己的能力。任务完成了,人的理解、判断和方法却不一定同步成长。
于是,从一个会使用 AI 的普通人,成长为一个真正能够掌控 AI 的人,将逐渐成为一道鸿沟。如何跨越这道鸿沟,会成为未来非常关键的问题。
